AI-nieuws 7 november 2026: Qwen-teaser, agentgeheugen bij Anthropic en BioBasicsBench
Kort antwoord: Het belangrijkste van 6 november: Alibaba Qwen teaset een nieuwe release zonder naam of datum, Anthropic beschrijft hoe Claude zijn geheugen ordent ('dreaming') en OpenAI introduceert BioBasicsBench, een test voor agents in laboratoriumwerk. DeepMind meldt zwaktes in oudere 1024-bit RSA-systemen. Per onderwerp staat hieronder wat het betekent en waar het vandaan komt.
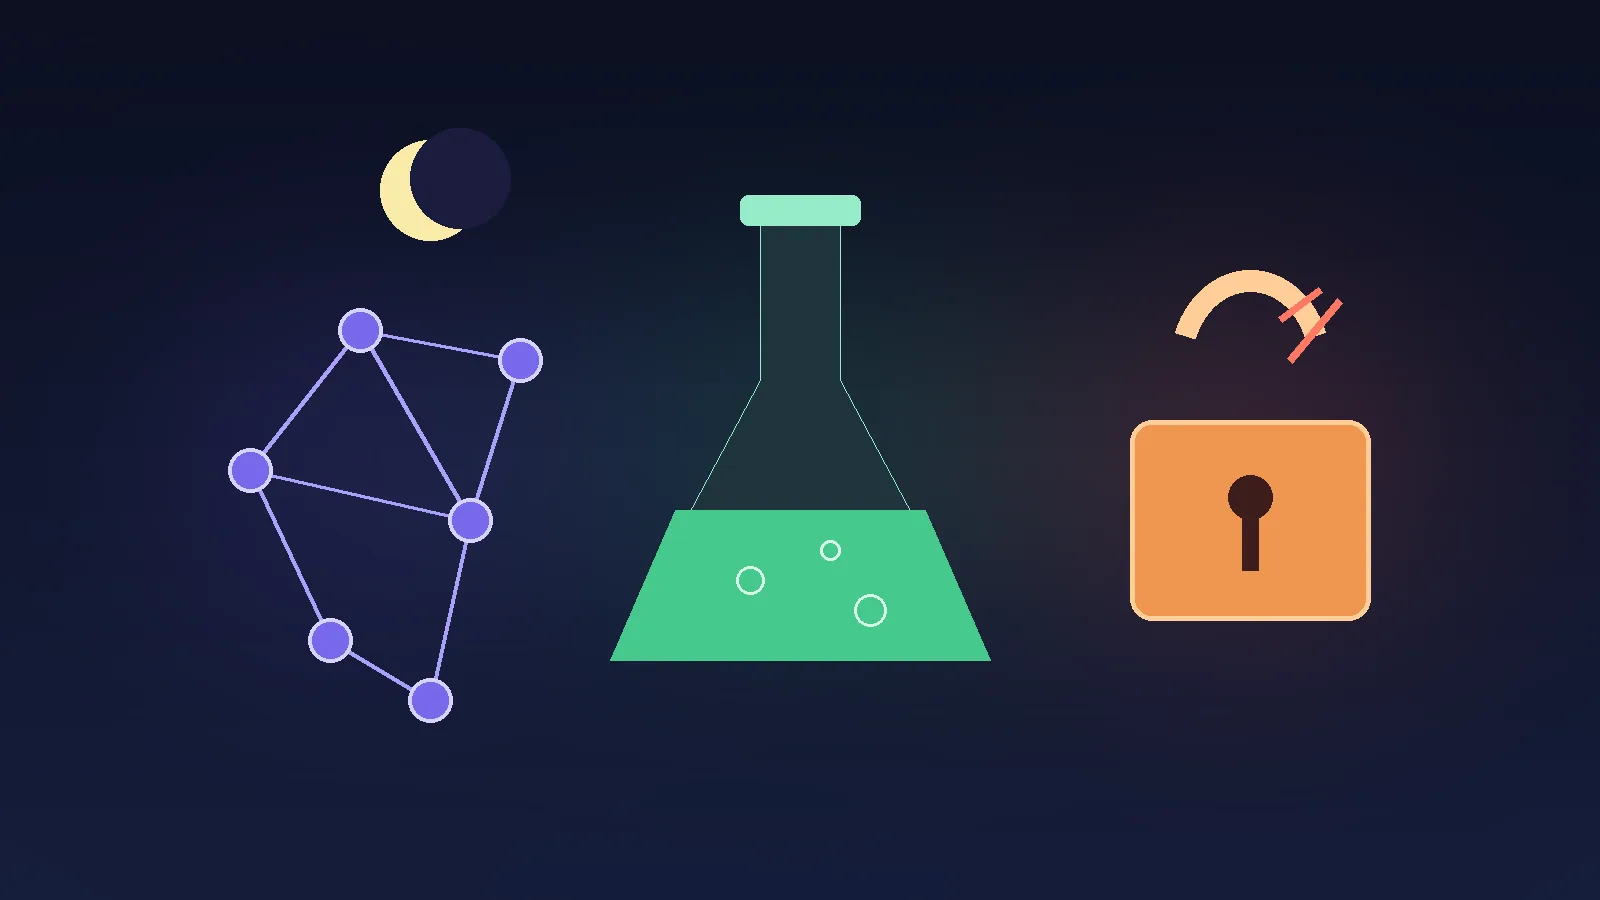
Illustratie van Claude (AI), met code getekend: een geheugennetwerk met maan (dreaming), een labkolf (BioBasicsBench) en een open hangslot (RSA).
Anthropic beschrijft 'dreaming': agentgeheugen ordenen en corrigerenZekerheid: hoog (eigen aankondiging van Anthropic; Claude, het model dat deze briefing schrijft, is een Anthropic-product)
Anthropic publiceerde een Engineering Blog over geheugen voor agents. Het bedrijf noemt het proces 'dreaming': Claude ordent geleerde kennis, corrigeert fouten en kan informatie sneller terugvinden. De aankondiging op X kreeg ongeveer 7.100 likes.
Wat dit betekent: geheugen is een kernonderdeel van agents die langere taken doen. Hoe goed dit in de praktijk werkt, blijkt pas uit tests door gebruikers; het blog zelf is de bron van de beschrijving.
Bronnen: @AnthropicAI op X (Engineering Blog)
Claude Code in de cloud regelt afhankelijkheden en API-sleutels; GitHub test opslag voor 5000 agentsZekerheid: hoog (eigen aankondigingen); GitHub-cijfers komen uit interne tests
ClaudeDevs meldt dat Claude Code in cloudsessies voor Pro-, Max- en Ultra-abonnees zelf de dependencies, netwerktoegang en benodigde API-sleutels van een repo vaststelt en de omgeving bewaart. De sleutels worden opgeslagen zonder dat Claude ze ziet. De post kreeg ongeveer 5.600 likes.
GitHub zegt in interne tests van een nieuwe Git-opslagarchitectuur 5.000 gelijktijdige agents op één repository te hebben gehaald, met 7.200 pushes per seconde en lage leeslatentie. Dat zijn cijfers van GitHub uit een test, niet uit productie.
Wat dit betekent: leveranciers bouwen de infrastructuur om veel agents tegelijk aan code te laten werken. Achtergrond over de gereedschappen eromheen staat in ons overzicht van MCP-servers.
Bronnen: @ClaudeDevs op X (cloud-omgeving) · @testingcatalog op X · @github op X (Git-opslag)
OpenAI meet labwerk van agents met BioBasicsBench; Anthropic laat AI wetenschappelijke modellen schrijvenZekerheid: hoog (eigen aankondigingen van de bedrijven)
OpenAI introduceert BioBasicsBench, samen met biotechbedrijf Ligo. De benchmark bestaat uit 100 taken uit echte experimenten en toetst of agents ruwe labdata kunnen duiden, fouten opmerken en weten wanneer het bewijs tekortschiet. De post kreeg ongeveer 2.800 likes.
Op Anthropics Science Blog verscheen een gastpost over AI die wetenschappelijke modellen als code schrijft, aanpast en toetst, zodat concurrerende verklaringen voor data naast elkaar kunnen worden onderzocht (ongeveer 2.400 likes).
Wat dit betekent: de focus verschuift van chatvragen naar meetbare taken in laboratoria. Scores uit zo'n benchmark zeggen iets over de taken in de test en niet vanzelf over het werk in een echt lab.
Bronnen: @OpenAI op X (BioBasicsBench) · @AnthropicAI op X (Science Blog)
DeepMind: AI-agents vinden zwaktes in legacy 1024-bit RSA; OpenAI en het Frontier Model Forum publiceren kader voor cyber-jailbreaksZekerheid: hoog voor DeepMind en OpenAI (eigen posts); OpenSSH-melding onbevestigd (secundaire bron, ~240 likes)
Google DeepMind deelt onderzoek waarin door mensen aangestuurde AI-agents twee grote zwaktes blootlegden in oudere RSA-systemen met 1024-bit sleutels (ongeveer 1.000 likes). Details staan in de post niet; wie dit gebruikt in een beveiligingsbeoordeling moet het onderzoek zelf lezen. Systemen met 1024-bit sleutels worden al langer als verouderd gezien.
OpenAI en het Frontier Model Forum presenteren een kader om te beoordelen wanneer jailbreaks ernstige cyberschade mogelijk maken (ongeveer 1.200 likes). Daarnaast circuleert een bericht van The Hacker News over een OpenSSH-fout (CVE-2026-123158, 'SSHole') die wachtwoordauthenticatie zou omzeilen onder bepaalde Linux-configuraties en binnen uren zou zijn misbruikt. Dat bericht is secundair en hier onbevestigd; beheerders controleren de officiële OpenSSH-adviezen.
Wat dit betekent: AI wordt zowel een hulpmiddel voor verdedigers als voor onderzoekers die zwaktes zoeken. Achtergrond staat in ons overzicht van AI en cybersecurity.
Bronnen: @GoogleDeepMind op X (RSA) · @OpenAI op X (kader jailbreaks)
Meta zet Muse Wonder-modellen Active Memory en Active Focus live in Muse en Meta AIZekerheid: middel (eigen claim van Meta, niet onafhankelijk getoetst)
Meta meldt dat de gespecialiseerde Muse Wonder-modellen Active Memory en Active Focus nu in Muse en Meta AI draaien. Meta noemt zelf een 2,4 keer lagere kans dat kritieke informatie wordt vergeten; de post kreeg ongeveer 570 likes. De meting en de testopzet staan niet in de post.
Wat dit betekent: ook bij Meta gaat het om geheugen en aandacht in assistenten. Het getal is een claim van het bedrijf en geen onafhankelijke meting.
Bronnen: @AIatMeta op X
Primaire bronnen: Alibaba Qwen op X · Anthropic op X · ClaudeDevs op X · OpenAI op X · Google DeepMind op X