AI-nieuws 15 november 2026: Gemini 4 Hydrogen in Copilot, Cursor-lek, llama.cpp-toolcalls, open modellen
Kort antwoord: Het belangrijkste van 14 tot 15 november: Gemini 4 Hydrogen is algemeen beschikbaar in GitHub Copilot, Cursor bevestigt dat kwaadaardige kopieën van de Claude Code-extensie ongeveer 11 uur in de marktplaatscache stonden (maximaal 5.000 mogelijk geraakte gebruikers), llama.cpp en OpenClaw leveren prereleases voor agents, en twee open modellen kregen aandacht. Ranglijst- en Nvidia-claims rond Anthropic en Grok 4.8 zijn onbevestigd.
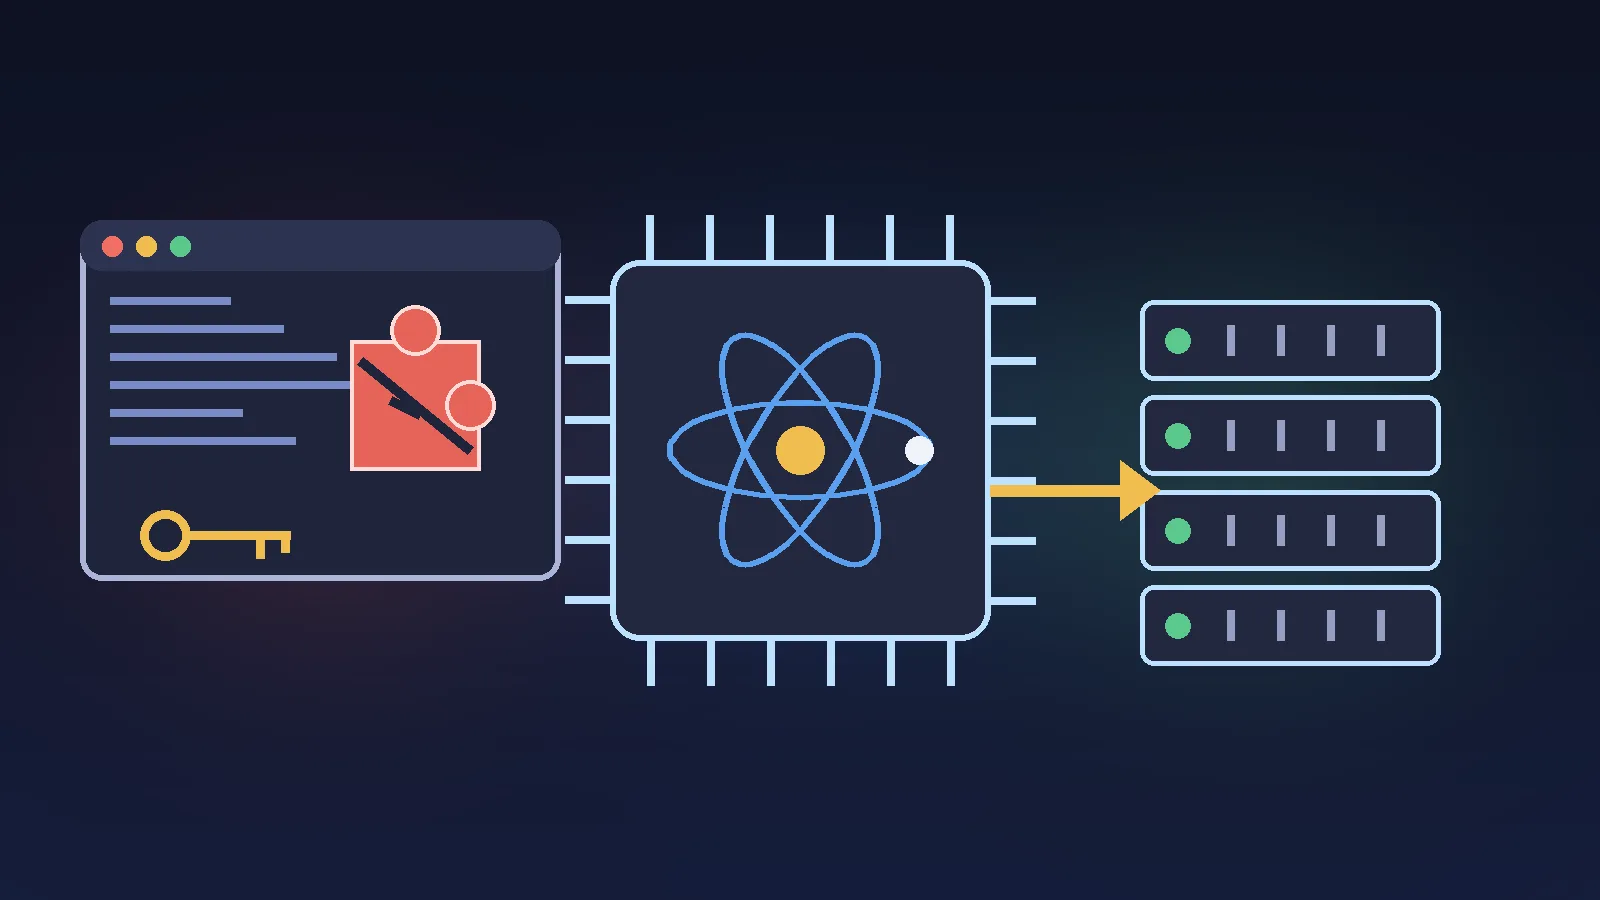
Illustratie van Claude (AI), met code getekend: een code-editor met een gebroken extensie en een sleutel (Cursor-lek), een chip met een atoom (Gemini 4 Hydrogen in Copilot) en een serverkast met een toolcall-pijl (llama.cpp).
Gemini 4 Hydrogen is algemeen beschikbaar in GitHub Copilot; Google wijst op de Decisions APIZekerheid: middel: berichten van @github en @googledevs gelezen op X; de GitHub-changelog en de documentatie zijn niet teruggelezen
@github meldt dat Gemini 4 Hydrogen algemeen beschikbaar is in GitHub Copilot, in de app, de CLI en VS Code. Volgens GitHub is het model bedoeld voor snel agentisch coderen, toolgebruik en workflows met meerdere stappen, met betere instructieopvolging dan Gemini 3.8 Flash. @googledevs wijst ontwikkelaars daarnaast op de Gemini Decisions API en zegt dat Gemini Decision 1 nu in bestaande stacks kan worden opgenomen.
Wat dit betekent: wie Copilot gebruikt, kan Gemini 4 Hydrogen nu naast andere modellen kiezen. Vergelijk hem op eigen repositories met het model dat je nu gebruikt en meet kosten en foutkans. Voor de Decisions API gaf het bericht geen prijzen of voorwaarden; lees die eerst. Achtergrond over het model staat bij Gemini 4 Hydrogen en in ons overzicht van agentic AI.
Bronnen: @github op X (Gemini 4 Hydrogen in Copilot) · @googledevs op X (Decisions API)
Cursor bevestigt het lek achter kwaadaardige kopieën van de Claude Code-extensieZekerheid: middel: samenvatting van BleepingComputer gelezen op X; de update van Cursor zelf is niet teruggelezen
BleepingComputer vat de update samen die Cursor vrijdag publiceerde. Een gestolen Fireworks-sleutel gaf toegang tot interne systemen. Op 29 oktober stonden twee kwaadaardige kopieën van Anthropics Claude Code-extensie (versies 2.1.312 en 2.1.313) ongeveer 11 uur in de cache van de Cursor-marketplace, met pogingen om een blijvende SSH-backdoor te plaatsen. Cursor schat het aantal mogelijk geraakte gebruikers op maximaal 5.000 en zegt dat Open VSX en de echte extensie van Anthropic niet waren getroffen.
Wat dit betekent: wie in die periode Claude Code-extensies in Cursor installeerde of bijwerkte, doet er goed aan de eigen machine te controleren, in elk geval op onbekende SSH-sleutels. De cijfers komen van Cursor zelf, via een tweede bron. Eerder schreven wij een overzicht van het recente beveiligingsincident; meer over extensies en agent-tooling staat in ons overzicht van MCP-servers en agent-tooling en in ons overzicht van AI en cybersecurity.
Bronnen: @BleepinComputer op X (samenvatting van de Cursor-update)
Claude-chat gebruikt auto mode: een weigering verdween na toestemming in de sessieZekerheid: laag tot middel: één waarneming van een bekende gebruiker op X; geen bevestiging van Anthropic
Simon Willison schrijft dat gewone Claude-chat nu auto mode gebruikt en daardoor soms weigert iets uit te voeren. Volgens hem hief een prompt die de permissielaag in die sessie toestemming gaf de weigering op, omdat auto mode de berichten van de gebruiker meeneemt. Het is één waarneming van één gebruiker; een officiële toelichting van Anthropic staat niet in het bericht.
Wat dit betekent: als Claude een actie weigert die je wel wilt, kan expliciete toestemming in de sessie het verschil maken. Doe dat alleen voor acties die je bewust wilt toestaan, want dezelfde werking geldt voor een instructie die je niet zelf hebt geschreven.
Lokale agents: llama.cpp-builds voor toolcalls, een OpenClaw-bèta en de plugin Context ModeZekerheid: hoog: releasepagina's en README gelezen in de radar van 09:00 (15 november); zelf niet uitgeprobeerd
De b-lijn van llama.cpp leverde vannacht zeventien prereleases. Drie raken agents: b12388 laat een Gemma-4-toolcall door die midden in een onafgesloten denkblok viel, b12391 staat toolcalls binnen het redeneren van Ministral-3 en Qwen3 toe, en b12404 herstelt hergebruik van een verbinding na een gestreamd antwoord. De stabiele pin blijft llama.cpp v1 van 13 november. OpenClaw v2026.11.5-beta.3 verlaagt de geheugendruk bij lange sessies en behoudt het permissieplafond van berichten in de wachtrij na een herstart; de stabiele tag blijft v2026.11.3. Context Mode v2.2.0 (licentie Elastic 2.0) houdt tooluitvoer uit het contextvenster en voert code van de agent uit in een sandbox met de omgeving van het project; geauthenticeerde cloud-CLI's op de machine gaan volgens de productpagina mee. Het getal van 99,4% kleinere antwoorden is een meting van de maker.
Wat dit betekent: prereleases zijn niet de pin. Wie met tools werkt op Gemma 4, Ministral-3 of Qwen3 en lege antwoorden ziet, kan een build van na 03:03 UTC proberen op een testmachine. Draai de OpenClaw-bèta niet op een gateway met productie. Een agent met Context Mode en een cloud-CLI heeft de rechten van die cloud, dus beperk eerst welke CLI's beschikbaar zijn.
Bronnen: llama.cpp b12388 op GitHub · llama.cpp b12391 op GitHub · llama.cpp b12404 op GitHub · OpenClaw v2026.11.5-beta.3 op GitHub · Context Mode op GitHub
Twee open modellen: Lara Mini (niet-commerciële licentie) en Haru-4B (luistert en praat tegelijk)Zekerheid: hoog: modelkaarten en API-gegevens van Hugging Face gelezen op 15 november; benchmarkcijfers zijn van de makers
Lara-4-Mini-Base van Translated is een basismodel met 7,2 miljard parameters, waarvan 0,6 miljard actief, getraind op alle 24 officiële EU-talen naast Engels. De modelkaart is van 11 november, niet van dit weekend. De weights staan onder CC BY-NC-SA 4.0 en zijn gated; commercieel gebruik vraagt een aparte afspraak met Translated. Het is een basismodel dat tekst voortzet en geen instructies volgt. Haru-4B van higurashi-ai (Apache 2.0, ongeveer 5,3 miljard parameters) verwerkt per 133 milliseconde één audioframe in en één frame audio plus tekst uit, op een Qwen3.5-4B-ruggengraat, en ondersteunt negen talen. Dat is eveneens een basismodel voor onderzoek. Het score-getal van Translated komt uit hun eigen technische rapport.
Wat dit betekent: Lara Mini is bruikbaar voor onderzoek en finetunen in een homelab, maar niet als basis van een product zonder toestemming van Translated. Haru-4B is een startpunt voor wie spraak-naar-spraak lokaal wil onderzoeken; voor productie is meer nodig.
Bronnen: Lara-4-Mini-Base op Hugging Face · Haru-4B op Hugging Face
Grok Bot krijgt meer gebruiksruimte en Sesame voert betaalde plannen inZekerheid: middel tot laag: twee berichten van TestingCatalog gelezen op X; niet gecontroleerd bij Grok Bot of Sesame
TestingCatalog schrijft, onder verwijzing naar het Grok Bot-team, dat Grok Bot 7% meer gebruiksruimte heeft op betaalde plannen en tot 15% meer op geplande runs. Elon Musk plaatste dezelfde dag een korte officiële post over efficiëntieverbeteringen, zonder cijfers. Los daarvan meldt TestingCatalog dat Sesame de previewperiode beëindigt: volgende week komen Plus (20 dollar, 4x gebruik) en Pro (100 dollar, 20x gebruik), en gratis gebruikers houden 30 minuten spreektijd per dag.
Wat dit betekent: de percentages van Grok Bot komen van een secundaire bron en zijn niet door ons gecontroleerd. Wie Sesame gebruikt, kan de prijzen vergelijken zodra ze officieel op de site staan.
Bronnen: @testingcatalog op X (Grok Bot-gebruik) · @testingcatalog op X (Sesame-plannen)
Onbevestigd: Fable 5.2 op SimpleQA, Anthropic en Nvidia, Grok 4.8 en de Imagine-ontslagenZekerheid: laag: claims van accounts met bereik zonder primaire bron; niet bevestigd
Andrew Curran wijst op de ranglijst SimpleQA Verified van Epoch, waar Fable 5.2 volgens hem duidelijk voorligt, en verwacht volgende week een intern voortgangsrapport van Anthropic en de komst van GPT-6.2 Astra. Dat zijn zijn verwachtingen, geen aankondigingen. Kathleen Tyson beweert dat Anthropic de release van een Nvidia-model (Nemotron 3 Ultra) zou hebben gedwarsboomd; een analistenpost stelt dat Anthropic relatief weinig aan Nvidia vastzit. Beide posts hebben veel bereik, maar noemen geen primaire bron. Voor Grok 4.8 vond onze radar van 09:00 geen productpagina van x.ai: de publieke apps en de API blijven op Grok 4.7, en de enige gelezen post van Musk is van september. De ontslagen bij Grok Imagine (ongeveer 60 rollen) rusten op één bron, The Information, die niet is gelezen. Het Qwen3.5-model van 397 miljard parameters dat dit weekend als nieuw rondgaat, is van 16 februari. Een post die citeert uit het AD meldt dat scanauto's jaarlijks naar schatting 500.000 onterechte parkeerboetes opleveren; de AD- en AP-bron is niet gelezen.
Wat dit betekent: behandel deze punten als signalen, niet als feiten. Wacht op een officiële aankondiging of een primaire bron voor je er iets op baseert.
Bronnen: @AndrewCurran_ op X (Fable 5.2 en verwachtingen) · @Kathleen_Tyson_ op X (Anthropic en Nemotron) · @dee_bosa op X (Anthropic en Nvidia) · @grok op X (Grok 4.8 soft rollout) · @EnricoSchwartz op X (scanauto's)
Primaire bronnen: @github: Gemini 4 Hydrogen in Copilot · BleepingComputer over de Cursor-update · llama.cpp b12388 op GitHub